Agent学习笔记(二)从记住经历到管理上下文
从经历日志与 RAG 出发,解释 MemGPT 的两层存储、消息队列,以及 Letta Memory Blocks 的挂载、读写和共享。
上一篇我们提到,调研做到一半,可以把资料、结论和进度记下来,下次再接着做。但假设已经读了几十篇论文,我们准备比较其中两种方法,应该重新打开哪些记录?刚才查到的结果要不要留下?项目约束应该每次重新搜索,还是一直放在眼前?
我们继续以日志压缩调研为例,把这些问题逐个展开。先看一份经历日志怎样变成可检索的记忆,再看 MemGPT 怎样安排本轮输入与外部存储,最后看 Letta 如何把其中的工作记忆做成可以管理的组件。
Memory Stream:一份不断追加的经历日志
做调研时,我们可能这样记录工作过程:
1 | 周一 09:00 确认项目要求:日志必须能够无损还原。 |
每条记录描述一次经历,新经历不断追加。2023 年的 Generative Agents 将这样的记录集合称为 memory stream。论文让小镇里的虚拟居民保存观察,每个记忆对象包含文字描述、创建时间和最近访问时间。需要作决定时,再从记录中选出本轮使用的部分。
选择时,系统结合 relevance、importance 和 recency,也就是与当前问题的相关程度、重要程度和最近使用情况。重要性由模型评分,recency 随距离上次访问的时间衰减,三项归一化后组合。系统还会生成 reflection,从具体经历提炼更高层的认识;反思与计划也能回到记忆记录中。具体机制见论文第 4 节。
借到日志压缩任务里,我们可以保存“论文 A 使用了什么数据”这样的观察,也可以形成“比较压缩率前要核对数据集”这样的经验。前者可以回到原文查证,后者包含归纳,需要保留依据和适用条件。几条经历支持一个判断,并不意味着这个判断对所有项目都成立。
这篇论文主要评价模拟居民的行为是否连贯、可信。我们可以借用它组织经历的方法;技术报告是否正确,还要用引用和实验条件来核对。
已经可以检索了,为什么还要看 MemGPT
假设所有调研记录都已保存,用户现在问:“上次为什么选了方案 A?”一种直接的实现是先查历史,再把查到的内容和问题交给模型:
1 | 用户问题 → 检索相关记录 → 问题与记录一起输入模型 → 回答 |
这是常见的简单 RAG 流程。RAG 讨论怎样用检索到的外部信息辅助生成,检索可以使用向量,也可以在具体系统中结合其他方法。这个概念并不限定只能检索一次;这里先用单次检索来理解。参见 RAG 原论文。
接下来会遇到另一些问题:刚才的用户问题和工具结果保存在哪里?“必须无损”这条约束要不要每轮都参与判断?历史对话超过窗口之后,哪些内容可以移出去?这些问题涉及输入的组织和记忆的维护,仅仅设置一个检索步骤,还没有把它们全部处理好。
MemGPT 研究的就是这类上下文管理。它让模型通过工具参与记忆读写,并用程序管理近期消息和容量。检索仍然可以是其中的一部分,因此 RAG 与 MemGPT 可以组合;我们不需要把它们理解成必须先后采用的两代方案。
对照原图:两大存储层,各自包含什么
先从一个区别入手:这条信息已经在本轮输入里,还是要查回来以后才能看见? MemGPT 据此区分 main context 和 external context。前者是本轮交给模型的内容,后者是当前输入之外保存的信息。这里的层级描述可见性与访问方式,不能按图里的方框数量来数层数。
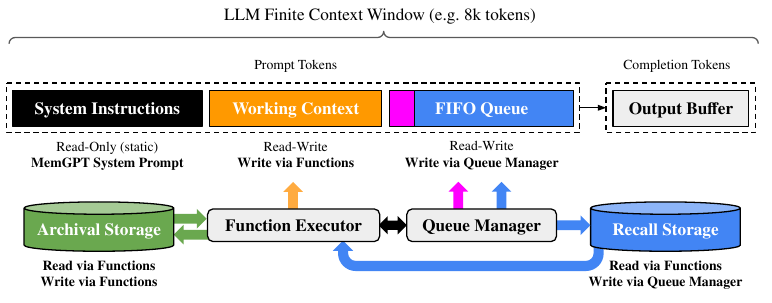
图源:Packer 等,MemGPT: Towards LLMs as Operating Systems,arXiv v2,第 3 页 Figure 3。
图中没有直接写出 Main Context,而是用 Prompt Tokens 标记对应的输入区域。它包含左上方的三个框:System Instructions、Working Context 和 FIFO Queue。右边 Output Buffer 表示模型输出;最上面的有限窗口括号还覆盖了输出区域,范围比 main context 更大。
把论文的层级与图中的名字对应起来,可以写成:
1 | Main context:本轮直接输入模型 |
System Instructions 规定运行规则及记忆工具的用法。Working Context 是可编辑的小块工作信息,适合放“必须无损”这样的任务约束。Recall Storage 保存消息历史,Archival Storage 保存归档文本;模型通过函数检索外部内容,结果重新进入输入后,才能在后续调用中使用。这些对应关系见 MemGPT 第 2 节。
因此,main context 与 Working Context 不是同一个范围。前者包含整个当前输入,后者只是其中专门保留重要信息的一部分。图里的名称也是 Recall Storage,指向历史的查回。
FIFO Queue 为什么有必要
先不考虑长期记忆。一个最普通的聊天程序,在第二轮请求里也需要带上近期对话,否则用户说“那压缩率呢”,模型就不知道正在比较哪两个方案。调用工具时也一样:程序要把调用记录和工具返回值交给后续的模型调用。
MemGPT 把这部分近期消息放在 FIFO Queue。Q 是 Queue,FIFO 表示先进先出。可以把它理解为带有容量管理的近期 messages 列表。比如一次查询可能逐渐积累出下面的记录:
1 | 用户:上次为什么选 A? |
下一轮输入会同时包含这段近期消息,以及 Working Context 中的“项目必须无损”等约束。两块内容都直接给模型看,但用途不同:工作区保存需要持续保留的要点,消息队列保留当前交互的来龙去脉。
随着对话增长,新消息追加进来,较早的消息会在容量不足时被移出当前输入。MemGPT 的 Queue Manager 还会维护递归摘要,完整消息则留在 Recall Storage。因而这里并非一个只会丢弃队首元素的普通队列,还有摘要与历史保存配合。机制见 论文 §2.1、§2.2。
如果我们把所有消息都放外面,每轮再检索回来,也能设计出另一种系统。但连刚才的追问和工具结果都要重新选择,可能增加检索开销,也可能遗漏当前交互所需的信息。保留近期消息,是为了让眼下的工作能够接续;更久远的内容再按需要查回。
Working Context 的用途也由此清楚了:如果“必须无损”只存在于很早的一条用户消息里,它可能随着队列滚动离开当前输入。把这条重要约束另外写进工作区,就能持续保留。究竟应该提取什么、有没有提取错误,仍是需要检查的决策。
一次读写,怎样经过这些区域
假设用户刚补充“本项目必须无损”,随后询问某个方案是否合适。下面是我们用来理解机制的交互示例:
| 时刻 | 系统里发生什么 | 信息所在的位置 |
|---|---|---|
| 收到新要求 | 程序追加用户消息,并保存历史 | FIFO Queue 与 Recall Storage |
| 保留重要约束 | 模型请求记忆编辑,执行器完成写入 | Working Context 增加“必须无损” |
| 查候选方案 | 模型请求查询归档的论文笔记 | 从 Archival Storage 取资料 |
| 返回查询结果 | 程序追加工具结果,再调用模型 | 结果进入 FIFO Queue,成为本轮输入 |
| 对话继续增长 | 程序移出较早消息并维护摘要 | 近期消息滚动,完整历史仍可查 |
这里有一部分由模型决定,例如要查哪份材料、是否保留某条约束。另一部分由程序完成,例如记录消息、监控容量和执行工具。模型不需要先调用一个“读取 main context”的工具,因为这些内容已经是它的输入。
也不存在 Working Context 只能配对查询 Recall Storage 的关系。查询结果可以先进入近期消息,模型看到之后,再决定是否把其中的要点写入工作区。MemGPT 还提供连续函数调用的控制方式,使一次用户请求能够经过多轮查询后再回答。参见 论文 §2.3、§2.4。
Letta:把这套设计发展成可管理的框架
现在我们已经知道 MemGPT 如何保存和取回信息,再来看 Letta。按照团队的命名说明,MemGPT 指原论文提出的设计模式,Letta 指后来扩展的 Agent 框架。MemGPT 原本就有持久化存储,也有可编辑的工作记忆;不能把 Letta 的贡献说成“终于让记忆能够保存下来”。
真正需要进一步解决的是工程管理:一个应用有多个 Agent,怎样分别维护它们的工作信息?开发者如何查看和更新某一块内容?哪些内容允许 Agent 改,哪些只能由应用更新?怎样让几个 Agent 使用同一份项目资料?Letta 把这些操作做成框架能力。Memory Blocks 是其中一个具体的抽象。
这里讨论的是 Letta 的 Memory Blocks。块的内容是可读写的文本,运行时会把它放进模型输入。理解它时,可以先想象我们把一份工作文档拆成几个有用途的小节,例如“项目约束”“已确认结论”“接下来待查的问题”。
一个 Memory Block,到底长什么样
假设我们给调研助手建立一块“已确认结论”。它在服务端可以表示为下面这样的对象。这里展示字段的含义,用来理解数据组织,并非可直接执行的 SDK 调用:
1 | id block-research-notes |
其中 value 才是记忆正文;label 和 description 说明这块内容的用途;id 让程序能够找到同一对象;容量与只读设置约束其使用。模型看到的具体格式由运行时的上下文模板决定,不必与上面的对象表示完全相同。Letta 的 Memory Blocks 说明 介绍了这类文本块及其持久化、编辑和上下文组装方式。
创建一个块、把块挂载到 Agent、让模型看到块内容,是需要区分的几件事。 服务端可以保存许多块,一个 Agent 只挂载其中相关的部分。在本文讨论的 core memory 机制中,已挂载块的内容会进入模型上下文,无须先通过语义检索挑中。没有挂载的块,不会因为存在数据库里就自动被这个 Agent 看见。官方 Memory Blocks 文档 给出了创建与挂载的说明;该页面目前归在 V1 SDK 文档中。
假设我们再建立一块 project_constraints,内容是“日志必须无损还原”,并把这两块都挂载给调研助手。下一次构建输入时,大致发生的是:
1 | 服务端保存的对象: |
这也解释了一个看似矛盾的地方:块既保存在数据库里,又属于上下文中的记忆。数据库保存的是持久化对象,模型输入里放的是运行时取出的文本。判断某条信息是不是 in-context,要看它是否进入了这次输入,不能只看它有没有存进数据库。
如果你原来已经在数据库里存了几段文本,每轮取出后拼进 prompt,那么你已经实现了这部分基本思路。Memory Blocks 的工程意义在于,把文本的身份、用途、挂载关系、读写操作和限制统一管理,避免每个应用重新安排这些操作。
块内容更新后,模型怎样用到新值
继续这个例子,助手找到了一项真正使用日志数据的实验,核对后准备把结论加入 research_notes。它先提出记忆工具调用,执行程序检查允许修改的块和内容限制,再更新保存的值。后续构建模型输入时,才会使用更新后的内容。
1 | 原 value:论文 A 的数据条件与日志不同。 |
在这里,更新数据库与模型说出“我记住了”是两件事。我们应该检查工具是否成功、保存的内容是否正确。一次已经发出的推理请求,也不会因为数据库随后发生变化,就自动修改它已经收到的输入。
只读块适合放不允许 Agent 自行改动的内容。例如,我们可以把 project_constraints 设成只读,让开发者或有权限的应用流程处理约束更新;research_notes 则允许工具编辑。Letta 文档提供了只读设置和块更新接口,但具体哪些内容应该允许修改,仍由应用决定。官方文档:只读块与更新
容量也要考虑。如果一块常驻记忆不断追加整篇论文,它就会挤占近期对话和工具结果的位置。对我们的助手,更合适的安排是让块保留短结论和来源指针,把长篇材料留在可检索的外部存储,需要时再取回来。这样,块解决“哪些要点持续可见”,检索解决“这次需要展开哪些材料”。
共享与持久化带来了什么,又没有保证什么
假设两个助手分别阅读不同论文,但都必须遵守“无损压缩”这项约束。我们可以让它们挂载同一个约束块。这样维护的是同一对象,后续构建各自上下文时使用它的当前内容;分别复制两段文本,则需要自己处理同步。Letta 支持块共享,也支持将块从某个 Agent 卸载;卸载移除挂载关系,不等于删除保存的块。官方文档:挂载与卸载
共享之后还会出现并发问题。两个分支同时编辑研究结论,可能互相覆盖;一个分支把未经核对的判断写入,另一个可能继续使用。我们可以在应用中检查版本、保留来源,或让一个受控流程统一提交。这些是共享可变状态需要继续解决的问题,不能从“支持共享块”直接推断一致性和事实正确性已经得到保证。
持久化也有相同的边界。重启后能重新取出工作记忆,不代表系统知道每个外部动作是否已经完成。比如报告写入成功后进程退出,恢复时还要核对文件真实状态。Memory Blocks 可以帮助保留任务信息,执行恢复仍需要 checkpoint、幂等和验收机制配合。
把几个概念放回各自的问题里
现在回头比较,就可以避免把它们排成一条谁全面替代谁的路线:
| 概念或方案 | 首先回答什么问题 | 对日志压缩调研的帮助 |
|---|---|---|
| Generative Agents 的 memory stream | 如何记录经历,并挑出有用的部分 | 保存阅读过程,按当前需要取回 |
| RAG | 如何用外部检索结果帮助生成 | 查回原论文和旧记录,再作答 |
| MemGPT | 如何管理有限输入与外部记忆 | 保留重要约束、滚动近期消息、按需读写 |
| Letta Memory Blocks | 如何管理可持续注入的工作记忆对象 | 为不同 Agent 挂载、编辑或共享有用途的文本块 |
对于每次只查稳定资料库的问答任务,我们可以从简单检索流程开始。任务持续多轮时,再考虑近期消息怎样滚动、关键约束怎样保留;多个 Agent 或长期服务需要管理同一批工作信息时,再评估框架提供的块管理能力。真正的选择依据,是当前系统在哪一步丢失了信息或失去了控制。
面试追问:长期记忆如何落地
“上下文、记忆和 checkpoint 有什么区别?” 上下文是当前这次调用的输入;记忆是系统保留、以后可能重新使用的信息;checkpoint 记录执行恢复所需的状态。三者可以引用同一份数据,但职责不同。保存了“报告已写完”的文字,恢复程序仍需确认文件是否真的存在、内容是否通过验收。
“为什么有了长上下文,还需要记忆管理?” 可以用一个反例说明:两份记录分别写着旧项目允许有损、新项目要求无损,即使都放得进去,也还要判断哪一条约束有效。窗口容量没有替我们完成信息筛选、时效判断和跨任务维护。是否需要更复杂的管理,再用任务效果和成本比较。
“记忆应该怎么写?” 在我们这个调研助手中,先抽取候选,再检查来源、复用价值和作用范围,最后提交。比如一条项目约束可以保存 content、source_id、project_id、valid_from、version 和 supersedes。这些字段是一个应用设计示例;不同数据不一定都需要同样的 schema。事件记录保留当时发生了什么,当前事实则要能表达更正和替代。
“检索为什么不能只做向量 Top-K?” 检索候选首先要属于当前用户和项目,之后才比较语义、时间与重要性。拿到候选后仍需处理冲突,再决定注入什么。假设查回了旧项目的优秀压缩结果,它可以作为参考资料,却不能覆盖新项目的无损要求。权限过滤应该尽量下推到检索范围,避免跨用户候选进入模型。
“遗忘是把向量删除吗?” 在我们的设计里,删除请求需要沿记录的派生关系传播。原文、向量索引、缓存和由它生成的摘要都可能持有信息。我们可以用 source_id 关联它们,并验证删除后是否还能通过检索、摘要或缓存读到旧内容。过期淘汰、错误更正和用户要求删除是不同操作,也应保留不同语义。
怎样验证记忆确实有用
给这个调研助手准备一组可核对的会话:第一次告诉它项目约束,隔几轮加入干扰材料,再追问;随后更改约束,观察它是否沿用旧值;最后删除其中一项,检查是否仍会回忆出来。另加一组没有相关历史的任务,检查系统会不会凭相似记录编造答案。
比较无长期记忆、固定摘要加检索、可编辑记忆三种实现时,保持模型和任务一致,记录正确率、过时信息引用、检索调用量和 token 成本。检索阶段有没有找回证据,与最终回答有没有正确使用证据,需要分开统计。这组实验是我们的验证方案,还没有运行。
记忆保存下来以后,下一轮仍要决定做什么。如果上一次已经失败,怎样利用记录改变下一次尝试?这就接到了下一篇的 ReAct、Reflexion 和 LATS。