Agent学习笔记(三)从 ReAct 到反思与搜索
沿着一次执行、失败重试和分支搜索,比较 ReAct、Reflexion 与 LATS,并讨论重规划、恢复和预算。
假设我们已经把日志压缩调研的资料保存好了,现在准备比较两个候选方案。先查压缩率,还是先确认数据集?查到的论文没有给出读取延迟,接下来是换一篇,还是找作者提供的代码?一个任务的大方向可以提前确定,具体路径往往要看到资料之后才能继续决定。
上一篇解决的是哪些信息能带到下一轮。这一篇我们接着看,拿到这些信息后,Agent 怎样选择动作,以及一次失败之后,下一次能怎样改进。
ReAct:让下一步跟着观察走
在已有的调研流程里,我们会边查边调整。文章说某种方法更快,我们打开实验部分,发现测试数据与日志相差很大,于是把它保留为参考,再继续找更接近的数据。这里每次阅读的结果都会影响后面的动作。
ReAct 把推理与环境交互放进同一条轨迹:模型依据已有信息选择动作,环境返回 observation,再据此继续。原论文使用自然语言 reasoning trace 帮助组织判断,行动则通过搜索或环境接口取得外部信息。论文在问答、事实核查和交互任务上研究了这种结合,方法与设置见第 2 至 4 节。
用我们的例子,可以把运行过程写成下面这样。这是说明机制的任务示例,并非论文原始轨迹,也不是要求生产系统展示模型的内部推理。
1 | 当前缺口:候选 A 的测试条件不完整 |
这里有两个不同的责任。模型提出下一步要查什么,执行程序真正发起查询,并把查到的内容作为工具结果返回。工具超时、没有结果和找到了反例,需要是不同的观察,否则模型会把“没查到”误解成“没有相关证据”。
ReAct 允许执行过程中调整方向,但一条轨迹仍可能卡住。比如搜索词一直变化,找到的却总是同一篇文章;或者助手反复说证据不足,却没有采取新的查证动作。实际系统因此还需要步数和费用预算、重复动作检测,以及明确的完成条件。
Reflexion:把一次失败变成下一次可用的经验
继续假设,第一版比较报告提交后,审阅发现它把不同硬件上的延迟直接放在一起排名。我们通常会记录这个错误,下次比较时先统一条件。Agent 也可以保留这样的反馈,但怎样组织它,才能真正影响下一次尝试?
Reflexion 区分 Actor、Evaluator 和 Self-reflection。Actor 产生轨迹,Evaluator 提供反馈,Self-reflection 将轨迹和反馈转成文字经验,存入 episodic memory,供后续尝试使用。反馈可以来自测试、环境奖励、规则或模型评估。其核心循环通过上下文中的经验调整行为,不更新模型权重。架构见论文第 3 节。
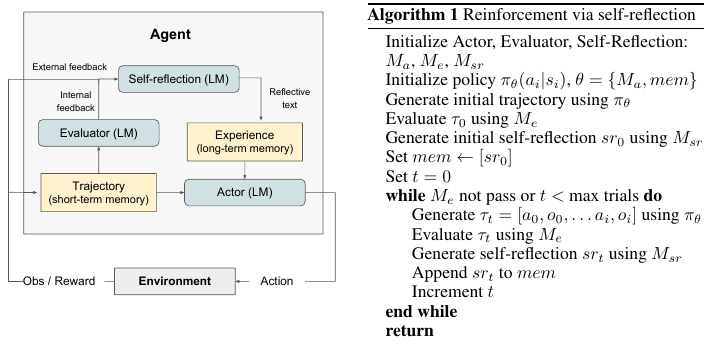
图源:Shinn 等,Reflexion: Language Agents with Verbal Reinforcement Learning,arXiv v4,第 4 页 Figure 2。
看左半边,环境反馈和轨迹进入评价与反思环节,生成的文字经验再影响 Actor。右半边把它写成多次尝试的算法。实现时要单独落实最大尝试次数、预算和成功判定,不能仅凭模型说“已经修正”就继续无上限重试。
对于我们的报告,“下次认真一点”没有提供新的行动条件。更有用的经验是:“比较延迟前,先核对硬件、数据量、压缩级别和统计口径;无法对齐时分别陈述,不直接排名。”它指出错误发生在哪里,也说明下一次应增加哪个检查。
不过,如果审阅本身判断错了,反思就可能把错误写得更加可信。我们可以让经验保留触发它的测试结果或原始证据,遇到新条件时重新检查。还有一点需要区分:Reflexion 中为后续尝试保留的经验,并不自动等同于经过授权、可跨任意任务使用的长期用户记忆。
LATS:从一条路径,走到多条路径的搜索
如果报告仍然没有足够证据,失败重来可能很浪费。假设在某个节点有两个方向:查原论文的附录,或查作者的复现仓库。我们希望保留这个分叉,试过一个方向后,还能回来尝试另一个。
LATS 将语言 Agent 与 Monte Carlo Tree Search 结合。它选择节点、采样多个后续动作,根据观察评价新状态,继续模拟轨迹,再把结果回传到树上;失败时生成反思帮助后续搜索。论文同时使用模型评价和 self-consistency 信号构造启发式价值。具体过程见第 4 节及 Figure 2。
在调研任务里,一个节点可以对应“已经读过这些材料、还缺这些证据”的状态,边对应下一次搜索或阅读。不同分支需要各自保留轨迹和材料来源,否则汇总时可能把一个分支的假设当作另一个分支已经验证的结论。
MCTS 常用的 UCT 选择规则可以简写为:
1 | UCT(s) = V(s) + c * sqrt(log N(parent(s)) / N(s)) |
V(s) 代表当前估计的价值,N(s) 是访问次数,c 调节探索程度。第一项偏向已有表现好的节点,第二项给尚未充分尝试的节点机会。新节点访问次数为零时,需要先探索或使用专门的初始化规则,不能直接代入分母。这里的价值回传更新搜索统计,与对语言模型做梯度反向传播不同。
搜索能否成立,还取决于环境能不能恢复。复制一段对话,并不会撤回已经发送的邮件或创建的订单。LATS 论文的讨论包含可在尝试间回退的任务条件;搬到真实业务里,我们应把搜索限制在可重置的环境、只读操作或隔离副本中,选定方案之后再执行有副作用的动作。
成本也会随分支增长。如果每个状态提出几个候选,每个候选又需要调用工具和模型评分,一次搜索可能比单条 ReAct 轨迹贵得多。因此,评价它有没有帮助,至少要让基线得到可比的调用或 token 预算。
三种方法的演变,落在不同的控制范围上
按问题理解这条线,会比只背算法名称容易一些:ReAct 处理一次执行中的观察与动作,Reflexion 在多次尝试间利用反馈,LATS 保留分支并搜索。Reflexion 可以使用 ReAct 作为 Actor,LATS 也能结合行动与反思;这些机制存在组合关系。
| 方法 | 主要改变的位置 | 需要保留什么 | 主要代价与限制 |
|---|---|---|---|
| ReAct | 当前轨迹的下一步决策 | 目标、动作和观察 | 可能循环或沿错误路径继续 |
| Reflexion | 下一次尝试的输入 | 失败轨迹、反馈、文字经验 | 依赖反馈质量,需要额外尝试 |
| LATS | 多条轨迹间的选择 | 搜索树、节点统计、分支状态 | 分支成本高,环境需支持回退 |
在我们的调研助手里,可以先让 ReAct 完成基本查证;如果常见错误能够由审阅发现,再加入带证据的反思;只有存在值得比较的分叉、又有足够预算时,才尝试搜索。这是针对这个任务的实现顺序,不是所有 Agent 都必须经历的升级路线。
面试追问:规划怎样变成可恢复的执行
“ReAct 与 Plan-and-Execute 怎样选?” ReAct 容易根据新观察调整下一步;Plan-and-Execute 可以先固定里程碑、依赖和验收,再让执行器完成各步。对这个调研任务,我们可以先规划“整理候选、核对证据、写报告”,每个里程碑内部再用 ReAct 查资料。是否重规划由新证据决定,不必在每次工具返回后重写全部计划。
“一个子任务要记录什么?” 以核对候选 A 为例,至少有 step_id、输入资料、依赖、当前状态、产物地址和验收条件。若会执行外部操作,再加权限、超时和幂等信息。验收可以是“实验数据与原论文一致,无法核对的字段标注缺口”,比“认真研究 A”更容易执行和检查。
“何时应该重规划?” 暂时超时可以有限重试;原论文证明某个前提不成立,则需要修改相关分支。比如候选 A 实际只支持有损压缩,就应调整候选集及其比较步骤,保留已经核实的其他候选。记录触发证据和 plan diff,有助于解释为什么计划变了,也能限制反复推倒重来。
“Reflection 算强化学习吗?” 介绍 Reflexion 时,应说明论文使用 verbal reinforcement learning 这个表述,核心做法是把反馈写成经验加入后续上下文。它不在这个循环里更新模型权重。如果面试继续问训练式 RL,再讨论奖励、策略优化和参数更新,避免把两种机制混在一起。
“怎么证明搜索或反思有效?” 我们可以比较单次 ReAct、相同预算的多次 ReAct、带反思的重试,以及搜索版本。固定模型、题目和外部环境,记录最终报告是否通过验收、错误是否重复出现、工具调用量与耗时。去掉反思或模型评分再运行,可以帮助判断收益来自哪个组件。这是拟议的验证方案,当前没有跑分结果。
“为什么有了计划,还是不能保证恢复?” 计划只描述想做什么。恢复需要知道哪些动作已经产生外部效果。假设文档写入成功,进程却在记录成功状态前退出,重启后应查询文档或使用幂等键,避免重复创建。模型重新生成一份计划,无法替代这一步核对。
接下来,执行路径已经有了,我们还要确保模型能够选对工具、传对参数,并正确理解返回结果。下一篇从 Toolformer 的训练方法开始,看这个问题怎样扩展到 API 检索和多步调用评测。